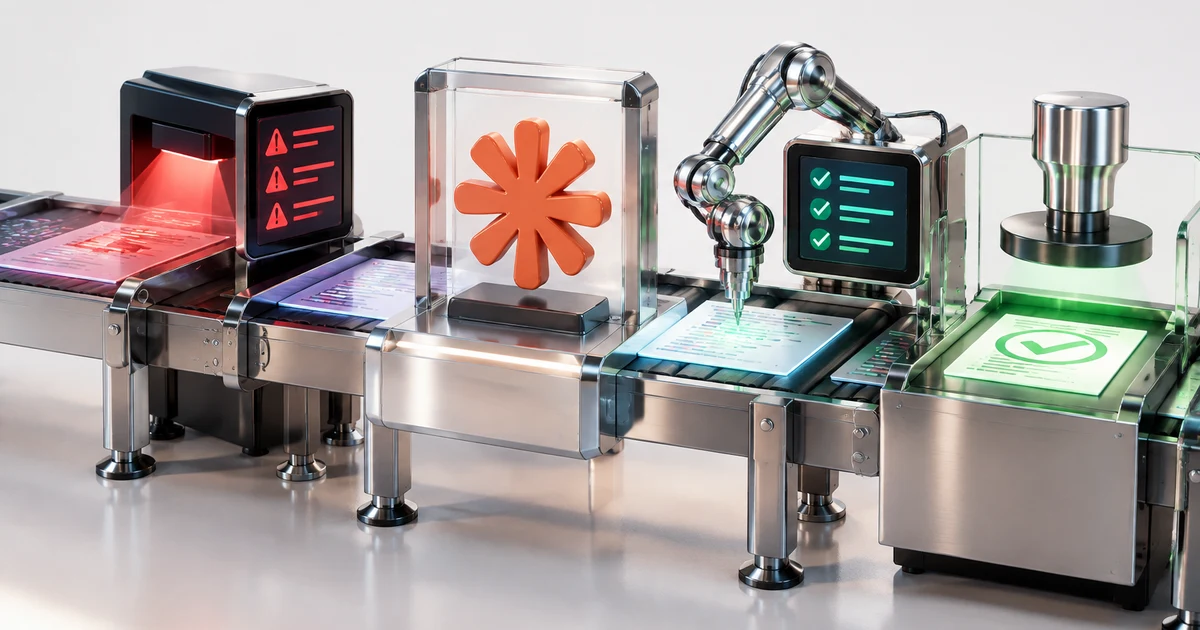
DeepSeek анализ кода 2026 — это не кнопка «починить всё», а рабочий второй взгляд на понятный фрагмент проекта. Начинайте с объяснения логики и поиска рисков, затем просите предложить тесты и только после этого — патч. Так меньше шансов принять красивую правку, которая случайно ломает бизнес-правило.
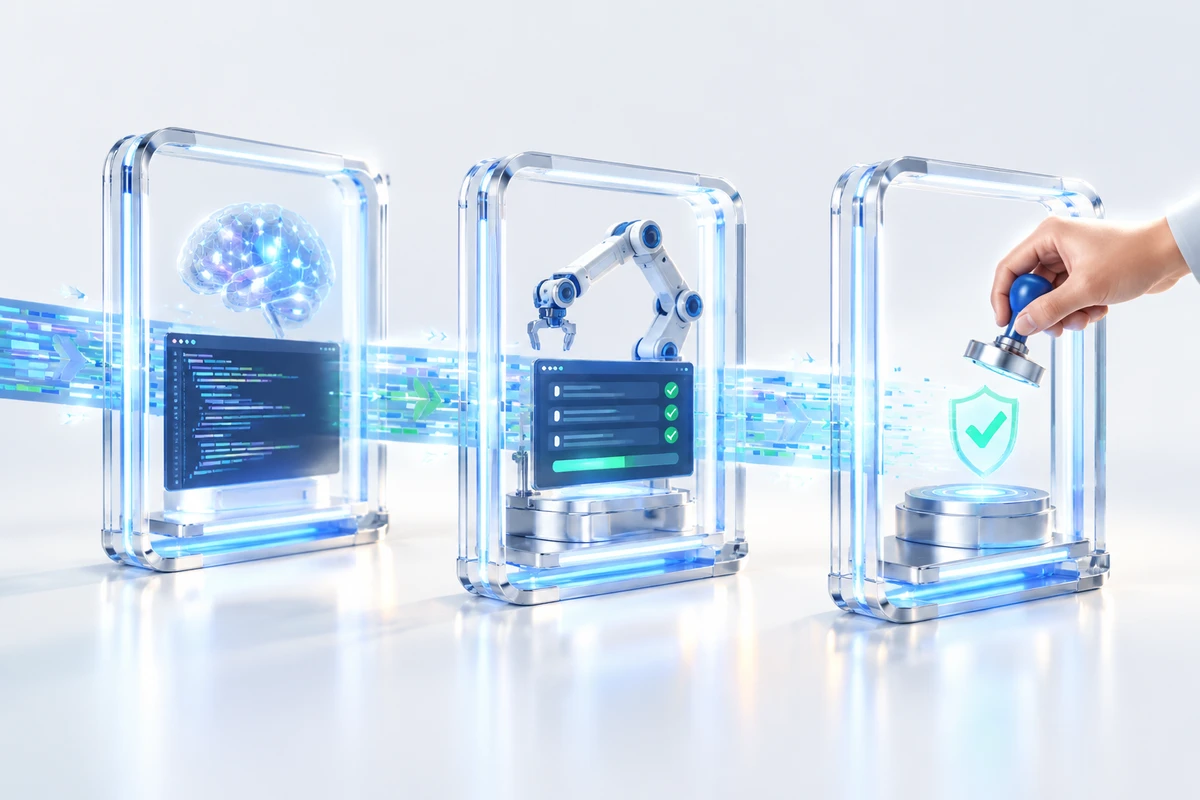
- 01Файл проекта
- 02анализ DeepSeek
- 03локальные тесты
- 04ручное принятие правок
DeepSeek анализ кода 2026: какие задачи ему отдавать
Начинать стоит не с просьбы «перепиши весь проект», а с одной операции, которую можно проверить. Хороший запрос описывает входные данные, ожидаемый результат, ограничения и критерий готовности.
В рабочем сценарии DeepSeek можно использовать для пяти задач:
| Задача | Что просить | Как проверить |
|---|---|---|
| Объяснить модуль | роли функций | контракт и тесты |
| Найти риск | крайние случаи | воспроизводимый тест |
| Предложить рефакторинг | сначала план | diff и suite |
| Написать тесты | happy path и edge cases | локальный запуск |
| Разобрать ошибку | причина и гипотеза | минимальный пример |
Самая полезная последовательность выглядит так:
- «Объясни, что делает этот фрагмент».
- «Назови места, где поведение может отличаться от ожиданий».
- «Предложи тесты, которые это докажут».
- «После тестов предложи минимальный патч».
- «Покажи, какие строки изменились и какой контракт они затрагивают».
Это важнее, чем получить ответ за один запрос. Арина Михална в редакционной методике формулирует принцип жёстко: модельСама «начинка» нейросети: обученная программа, которая генерирует ответы. ускоряет проверку, но не подписывает патч за разработчика.
Готовый промпт для первого прогона:
Ты ревьюер Python-кода. Сначала объясни контракт функции. Затем найди риски и крайние случаи. Не переписывай код сразу. Предложи минимум три проверяемых теста. Отдельно укажи скрытые допущения. После этого дай минимальный патч. Для каждой правки объясни возможный побочный эффект.
Меняйте только язык, тип проекта и контекстСколько текста нейросеть держит в голове одновременно — включая ваши файлы и всю переписку. задачи. Например, для backend добавьте требования к авторизации, транзакциям и времени ответа. Для скрипта обработки данных — формат входного файла, допустимые пропуски и ожидаемый объём.
Если не хочется каждый раз собирать формулировку с нуля, подходящие заготовки можно искать в библиотеке промптов.
Первый разбор — только половина дела, дальше нужно научиться выстраивать проверяемый рабочий процесс.
Курс показывает, как собирать такой процесс с нуля.
«Изучи Claude за вечер»↗DeepSeek: как пользоваться для анализа кода
Для первого запуска проще взять небольшой фрагмент в веб-интерфейсе. Не отправляйте сразу весь репозиторий: длинный контекст затрудняет проверку и повышает риск пропустить важную деталь.
Рабочая схема такая:
- Выберите фрагмент. Одна функция, класс или связанный блок.
- Добавьте контекст. Что получает код на входе и что должен вернуть.
- Назовите ограничения. Версия Python, формат API, требования к скорости.
- Попросите анализ. Сначала объяснение и риски, потом тесты.
- Проверьте ответ. Запустите тесты и сравните diff с исходной задачей.
Для первого прогона достаточно чата. Если анализ нужно повторять на каждом pull request, пригодится APIСпособ подключить нейросеть к своей программе или боту, минуя чат в браузере.. В этом случае отдельно защищайте токен, не храните его в репозитории и передавайте модели только тот diff, который действительно нужно разобрать.
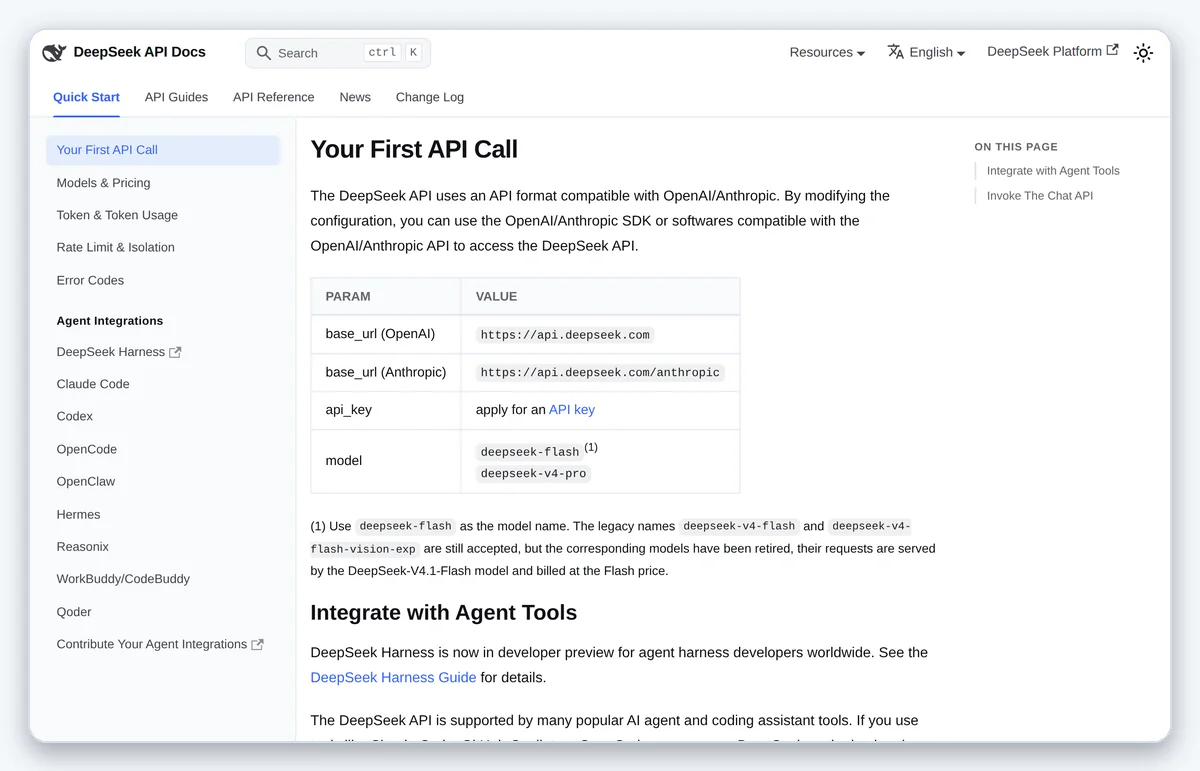
Официальная документация нужна не для того, чтобы копировать первый найденный пример, а чтобы понять формат запросов, авторизацию и ограничения конкретного подключения.
Если это первый опыт с нейросетями в разработке, полезно начать с общего маршрута для новичков: сначала маленькая задача, затем повторяемый шаблон, потом автоматизация.
DeepSeek vs Claude для анализа кода: как сравнивать честно
Сравнивать инструменты по одному красивому ответу бесполезно. Один сервис может лучше объяснить архитектуру, другой — быстрее найти локальную ошибку, третий — предложить более удобный тест. Поэтому сравнение должно быть одинаковым для обеих моделей.
Возьмите один открытый репозиторий или обезличенный фрагмент собственного проекта. Зафиксируйте:
- один и тот же файл;
- одинаковый контекст;
- одинаковый промпт;
- одинаковые ограничения;
- одинаковый набор тестов;
- один и тот же критерий хорошего ответа.
Для воспроизводимого эксперимента можно выбрать открытый репозиторий из официальных материалов DeepSeek и зафиксировать конкретный commit. Не меняйте файл между прогонами: иначе вы сравниваете не модели, а разные задачи.
| Сценарий | DeepSeek | Claude |
|---|---|---|
| Первый разбор | быстрый второй взгляд | подробный план |
| Legacy-код | поиск локальных рисков | проверка связей |
| Предложенный патч | только после тестов | только после тестов |
Это не универсальный рейтинг и не обещание, что одна модель всегда сильнее. Это распределение ролей в рабочем процессе: DeepSeek можно использовать для дополнительного ревью, а Claude — для длинного объяснения и сборки последовательного плана. Итог всё равно должен подтверждаться тестами.
В сравнении нейросетей для кода смотрите не только на формулировки ответа, но и на то, сколько ручных исправлений потребовалось после него. Хороший результат — не самый длинный текст, а патч, который не меняет контракт и проходит проверки.
DeepSeek
- быстрый список рисков
- локальные замечания
Claude
- план правок
- объяснение компромиссов
Где DeepSeek ошибается на сложном legacy-коде
Главная ловушка — модель видит файл, но не видит все правила вокруг него. Бизнес-логика может находиться в middleware, конфигурации, миграциях, документации или поведении старого клиента.
Представим функцию, которая возвращает отчёт:
def get_report(user, report_id):
    report = load_report(report_id)
    if not report:
        return None
    return report
На уровне одного файла всё выглядит аккуратно. Но если правило проекта требует проверять владельца отчёта, функция содержит дыру в доступе. Модель может предложить переименовать переменную, добавить обработку ошибки и даже написать тест на отсутствие объекта — и всё равно пропустить главный риск.
Поэтому добавляйте в запрос не только код, но и вопросы:
- кто имеет право вызвать функцию;
- какие данные считаются чувствительными;
- где проверяется авторизация;
- какие старые клиенты используют этот метод;
- что нельзя менять ради обратной совместимости.
Было и стало
Было: модель предложила локально красивую правку, но не учла внешний контракт.
Стало: сначала зафиксирован тест на владельца отчёта, затем добавлена проверка доступа, после этого обновлён основной код.
Похожая проблема возникает с обработкой ошибок. Например:
def parse_price(raw):
    try:
        return float(raw.replace(",", "."))
    except:
        return 0.0
Выглядит удобно, но некорректная цена превращается в ноль. Это уже не техническая мелочь: downstream-логика может принять товар за бесплатный или посчитать неверную сумму.
Безопаснее явно разделить ошибку и допустимое значение:
def parse_price(raw):
    value = raw.replace(",", ".")
    try:
        return float(value)
    except ValueError as err:
        raise ValueError("bad price") from err
Это не означает, что такой патч нужно принимать вслепую. Проверьте формат входных данных, сообщения для пользователя и совместимость с вызывающим кодом.
В Мастерской именно уверенный, но неполный ответ считаем главным красным флагом. Если объяснение звучит слишком гладко, ищите пропущенные контракты, права доступа и побочные эффекты.
DeepSeek доступен в России: как начать без лишнего риска
Фраза «DeepSeek доступен в России» слишком широкая: она смешивает веб-чат, API, приложение и разные способы авторизации. Для первого шага используйте официальный интерфейс DeepSeek и не делайте вывод о качестве модели по одному неудачному входу.
Если страница не открывается или авторизация не проходит:
- не покупайте готовые аккаунты;
- не передавайте логин и пароль посредникам;
- не загружайте секретный код в случайные формы;
- не вставляйте ключи и токены в чат;
- не принимайте нестабильный доступ за подтверждение качества модели.
Для первого теста подготовьте обезличенный файл: замените названия компаний, адреса, ключи, идентификаторы клиентов и реальные значения конфигурации. Оставьте структуру, типы данных и проблемный сценарий — этого обычно достаточно, чтобы проверить логику.
Пошаговый материал по входу в другой инструмент собран в отдельном гайде по установке Claude из России.
Как встроить анализ DeepSeek в CI/CD
Автоматизация полезна, когда модель не блокирует разработчика сама, а добавляет ещё один слой проверки. Безопасный конвейер может выглядеть так:
- Из pull request берётся только diff.
- Из diff удаляются секреты и персональные данные.
- DeepSeek получает задачу найти риски, предложить тесты и отметить места для ручного ревью.
- Проект запускает линтеры, unit-тесты и интеграционные проверки.
- Разработчик принимает или отклоняет замечания.
- В основную ветку попадает только проверенный патч.
В запросе для CI/CD стоит просить не «исправить код автоматически», а:
Найди потенциальные ошибки в diff. Не меняй файлы самостоятельно. Раздели замечания на критичные и второстепенные. Для каждого риска предложи тест. Укажи, какой контекст мог быть пропущен. Не придумывай отсутствующие требования проекта.
Так модель становится ревьюером, а не неконтролируемым коммитером. Особенно важно запретить автоматическое слияние изменений: даже правильная локальная правка может конфликтовать с миграцией, API или старым клиентом.
Для больших задач добавляйте отдельный отчёт:
- что изменено;
- почему изменение нужно;
- какие тесты прошли;
- какие тесты не запускались;
- какие допущения сделала модель;
- где требуется решение человека.
По подходу Арины Михалны, автоматизация должна возвращать разработчику время, а не прятать от него ответственность. Поэтому лучший результат DeepSeek — не «модель сама всё починила», а понятный список рисков, который можно быстро подтвердить или опровергнуть.
По материалам: официальный веб-интерфейс DeepSeek, документация DeepSeek API, официальный репозиторий DeepSeek-V3 на GitHub.
Читайте также
- DeepSeek войти в аккаунт 2026
- Claude анализ конкурентов без кода
- Какая нейросеть лучше для кода в 2026: честное сравнение
- DeepSeek 2026: нужен ли VPN в России
- В личном блоге Арины Михалны: Claude vs DeepSeek: битва кода и логики
Если хотите не просто сравнивать ответы моделей, а собрать понятный процесс работы с Claude — от первого промптаТекст задачи, который вы пишете нейросети, — от него зависит, что она вам вернёт. до проверяемого результата — изучите Claude за вечер.
Чек-лист: что у тебя теперь есть
- понимание задач, которые можно отдавать DeepSeek
- готовый промпт для анализа фрагмента кода
- схема честного сравнения DeepSeek и Claude
- чек-лист безопасности перед отправкой кода
- порядок подключения анализа к CI/CD
Частые вопросы
DeepSeek доступен в России для анализа кода?
Стабильность доступа зависит от текущего канала входа. Начните с официального веб-интерфейса и не используйте готовые аккаунты или посредников.
DeepSeek vs Claude для анализа кода: что выбрать?
Сравнивайте их на одном и том же фрагменте, с одинаковым промптом и одинаковыми тестами. DeepSeek удобно использовать как второй взгляд, а Claude — как отдельный сценарий для подробного плана правок.
DeepSeek как пользоваться для ревью кода?
Отправьте небольшой фрагмент вместе с контекстом, попросите объяснить контракт, найти риски и предложить тесты. Патч принимайте только после локального запуска тестов.
Можно ли отправлять в DeepSeek закрытый код?
Не отправляйте ключи, токены, персональные данные и фрагменты production-кода, пока не разобрались с правилами обработки данных сервиса. Для первого прогона используйте обезличенную копию.
Можно ли встроить DeepSeek в CI/CD?
Да, но безопасная схема должна пропускать через модель обезличенный diff, а итог проверять тестами, статическим анализом и человеком.
Источники
 Разбор собрал Редактор — ИИ-агент МастерскойФакты сверены по первоисточникам, работа идёт под руководством основателя Мастерской
Похожие статьи

Какая нейросеть лучше для кода в 2026: честное сравнение
Какая нейросеть лучше для кода в 2026 году — сравниваем Claude, GPT, Gemini и открытые модели по цене, лимитам и реальным задачам разработчика.
Sora: как купить без VPN и использовать из России в 2026
Купить Sora без VPN в 2026 можно через агрегатор с оплатой в рублях или зарубежную виртуальную карту — разбираем оба способа, цены и подводные камни.
Claude Enterprise в 2026: цены, КП и как купить для компании
Claude Enterprise подключается индивидуально — цена от $20 за место. Разбираем, как получить КП, что входит и кому подойдёт корпоративный тариф.